Tu veux un site qui tourne, tout le temps, sans mauvaise surprise. Le cœur du sujet, c’est un monitoring WordPress fiable qui va au‑delà d’un simple “site UP”. Dans les 200 premiers mots, posons les bases : monitoring WordPress, uptime, cron, synthetic monitoring, alerting, SLO et notifications. Ces mots‑clés sont la colonne vertébrale d’un dispositif qui protège ton chiffre d’affaires et ta réputation. Un bon monitoring détecte les vraies pannes et les régressions cachées (formulaire qui ne part plus, cron bloqué, paiement qui échoue), alerte les bonnes personnes au bon moment, et reste silencieux le reste du temps. Ton objectif n’est pas d’avoir plus d’alertes, mais d’avoir uniquement les alertes actionnables.
Dans ce guide, on construit un monitoring utile pas à pas : sondes d’uptime multi‑régions, suivi du cron (WP‑Cron vs cron système), synthetic monitoring des parcours critiques (lead/contact, checkout WooCommerce), SLO concrets (ex. 99,9 % d’uptime HTTP 200/TTFB < 800 ms, 99 % de succès formulaire), et un alerting sans bruit grâce à des seuils pertinents, de la déduplication et des notifications intelligentes. On t’indique aussi comment éviter la “fatigue d’alerte” qui détourne ton équipe des vrais incidents. En bonus : une checklist d’implémentation rapide et des conseils pragmatiques pour TPE/PME et indépendants. Et si tu veux gagner du temps, l’équipe WP Builders peut tout mettre en place pour toi et rester en sentinelle 24/7.
Pourquoi un monitoring WordPress pro change la donne
Un site peut être “up” mais brisé : formulaire de contact en erreur silencieuse, cron en rade qui stoppe l’envoi d’emails, ou checkout qui tourne en boucle. Sans monitoring WordPress orienté métier, tu découvres le problème par tes clients. Avec un dispositif complet, tu détectes tôt, tu qualifies vite, et tu répares avec un runbook clair. Résultat : MTTD (temps de détection) et MTTR (temps de résolution) en chute libre, moins de stress et une meilleure expérience utilisateur.
- Disponibilité réelle (SLI) au lieu d’un simple ping.
- Parcours critiques testés automatiquement.
- Alerting basé sur des SLO et un budget d’erreur.
- Notifications ciblées, sans bruit inutile.
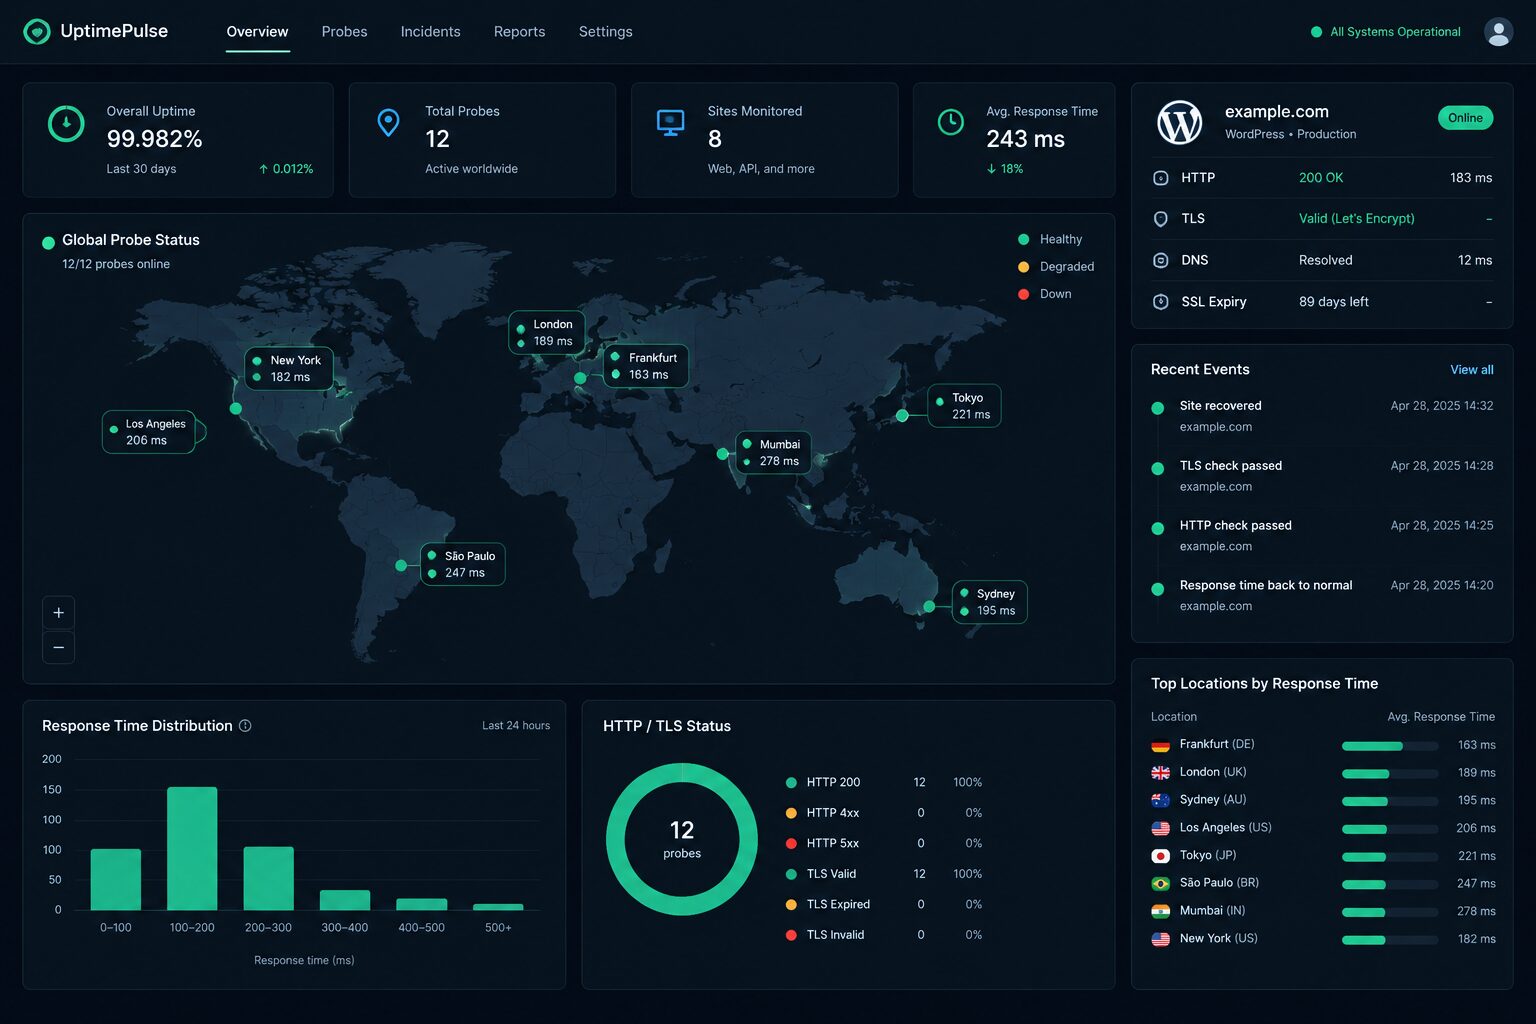
Uptime monitoring intelligent : au‑delà du ping
L’uptime ne se résume pas à “200 OK”. Pour réduire les faux positifs et repérer les dégradations, conçois tes sondes comme de vraies requêtes client :
- Multi‑localisation (Europe, US, Asie) + règle de quorum (2/3 échecs) pour éviter les alertes locales.
- Vérifications HTTP : code 200, TTFB seuilé (ex. 800 ms), signature de contenu (“wp‑content” ou une balise unique).
- Contrôles TLS/DNS : expiration du certificat, CAA, propagation DNS, réponse CDN.
- Fenêtres de maintenance pour ne pas alerter pendant les déploiements planifiés.
Astuce : maintiens deux sondes par environnement (prod/staging) et taggue les ressources (site, marque, criticité). Centralise l’historique pour prouver le respect de tes SLO.
Suivre et fiabiliser le cron WordPress (WP‑Cron vs cron système)
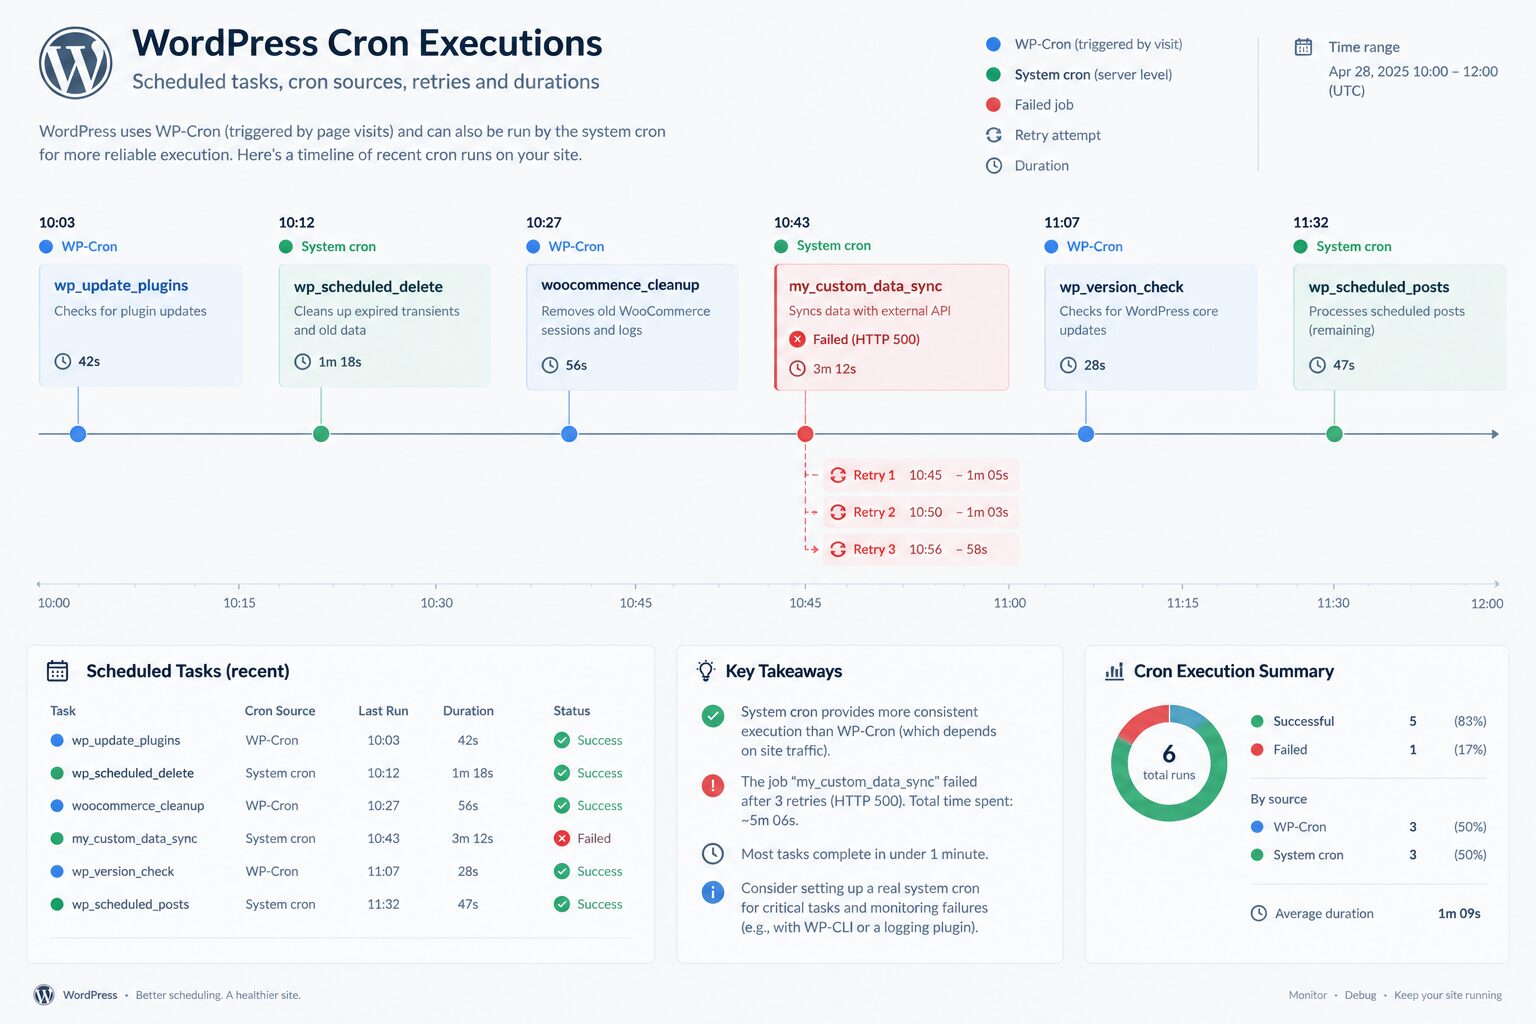
Le cron orchestre les tâches en arrière‑plan : envoi d’emails, indexation, synchronisations, WooCommerce Action Scheduler, etc. Par défaut, WP‑Cron dépend du trafic et peut rater des exécutions lors de périodes calmes. Passe à un cron système (toutes les minutes) qui appelle wp‑cron.php, et observe les jobs (succès, durée, retards, erreurs). La documentation WordPress Cron détaille les hooks utiles pour instrumenter.
# Exemple de cron système (Linux)* * * * * www-data /usr/bin/php /var/www/html/wp-cron.php >> /var/log/wp-cron.log 2>&1# Vérifier l’état avec WP-CLIwp cron event listwp cron event run --due-now- Instrumentation : journalise les débuts/fins de jobs, la durée et la cause d’échec.
- Seuils : alerte si un job critique dépasse X minutes ou manque N occurrences.
- Action Scheduler (WooCommerce) : surveille la file, les “failed” et le temps moyen de traitement.
Synthetic monitoring des parcours critiques (formulaire, checkout, recherche)
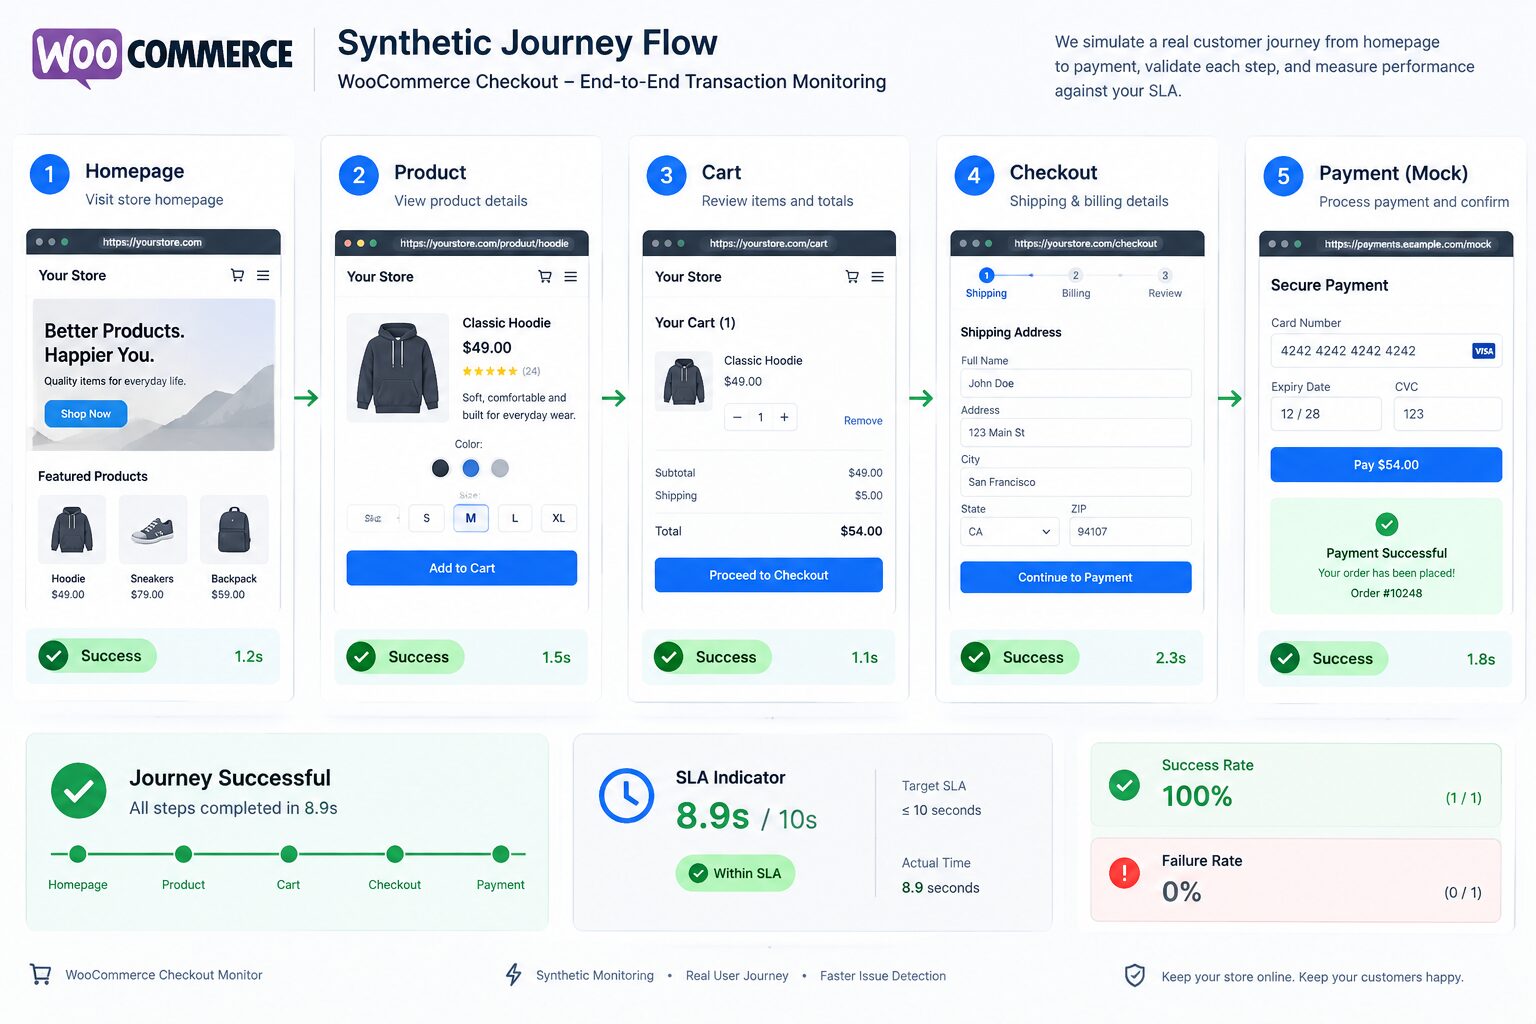
Les tests synthétiques rejouent le parcours d’un utilisateur pour valider les fonctionnalités réelles : soumission d’un formulaire, ajout au panier, paiement simulé, recherche interne. Ils détectent ce qu’un simple ping ne voit jamais.
- Définis tes parcours : Contact/Lead, Checkout WooCommerce, Espace client.
- Utilise des données de test (compte sandbox, carte de test) et nettoie automatiquement.
- Vérifie plusieurs assertions : code HTTP, texte de succès, redirections attendues, cookies/session.
- Gère l’authentification (nonce WordPress, cookies sécurisés, 2FA si nécessaire).
- Exécutions réparties (toutes les 5‑15 minutes) avec captures HAR et screenshots pour diagnostiquer.
Définir SLI et SLO WordPress orientés expérience
Sans SLO, tes alertes n’ont pas de cap. Les Service Level Indicators (SLI) quantifient la qualité, les Service Level Objectives (SLO) fixent le niveau à atteindre. Exemples :
- SLI Uptime : pourcentage de requêtes 200 avec TTFB < 800 ms.
- SLI Formulaire : ratio de soumissions validées en < 3 s avec email/sauvegarde confirmés.
- SLI Checkout : ratio de paiements “paid” avec latence < 5 s et taux d’échec < 1 %.
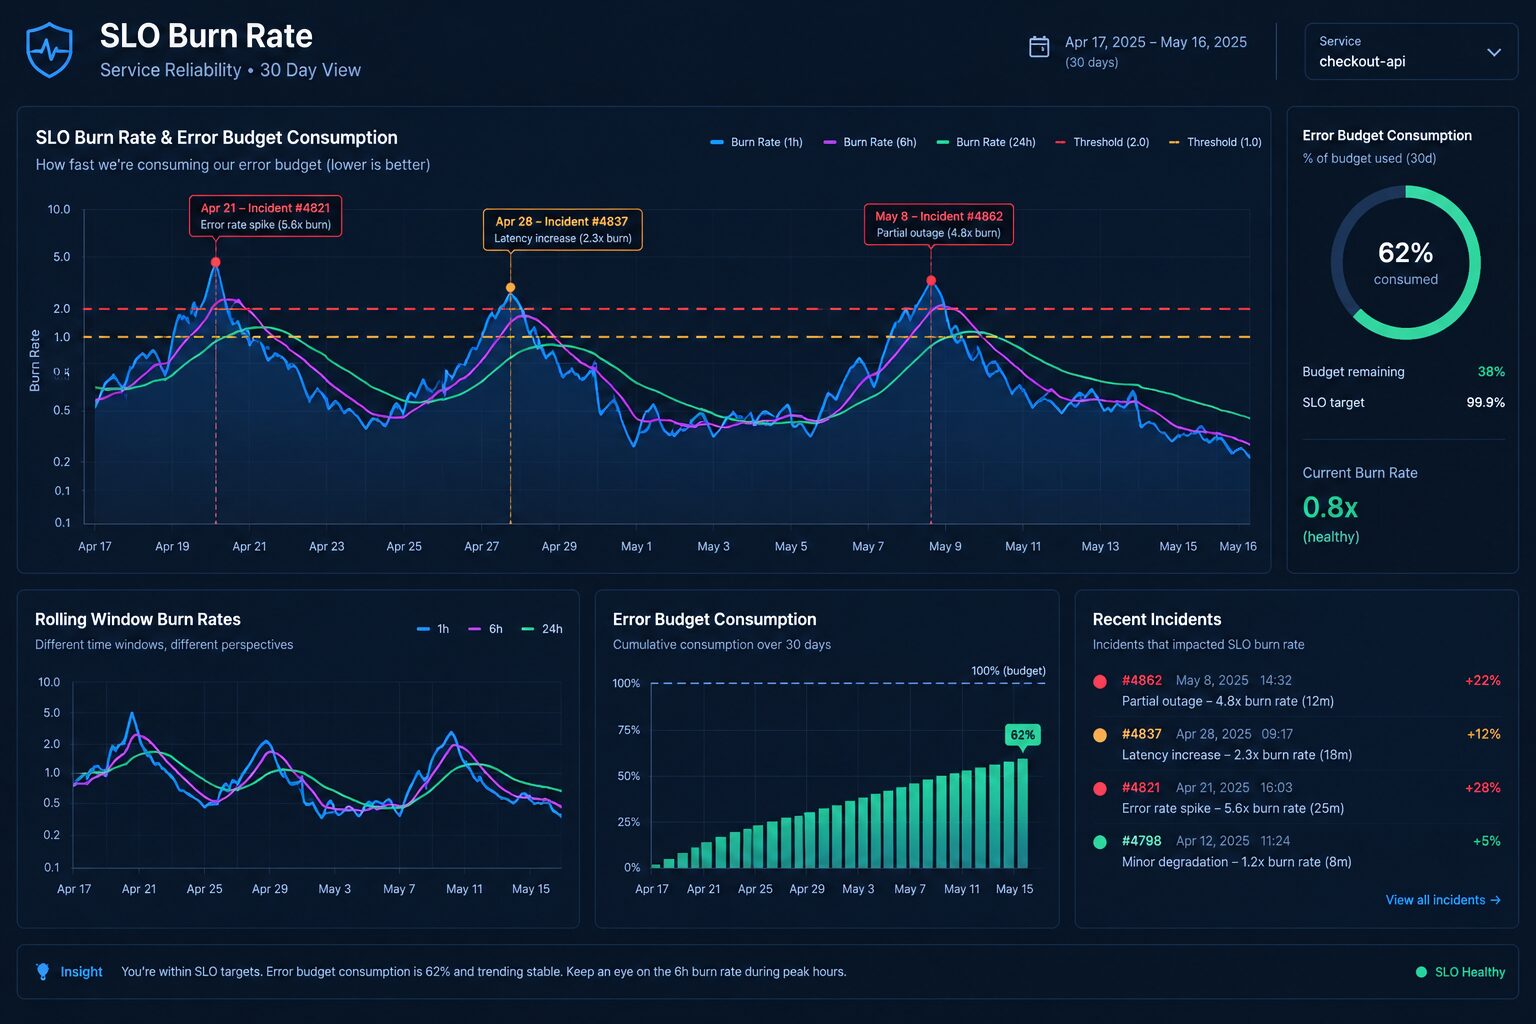
Fixe des SLO réalistes (ex. 99,9 % uptime, 99 % succès formulaire, 99,5 % checkout) et calcule un budget d’erreur. Utilise ensuite des alertes burn rate (consommation rapide du budget) plutôt que des seuils bruts. Le guide SRE sur l’alerting basé SLO illustre d’excellentes stratégies multifenêtres.
Alerting et notifications sans bruit
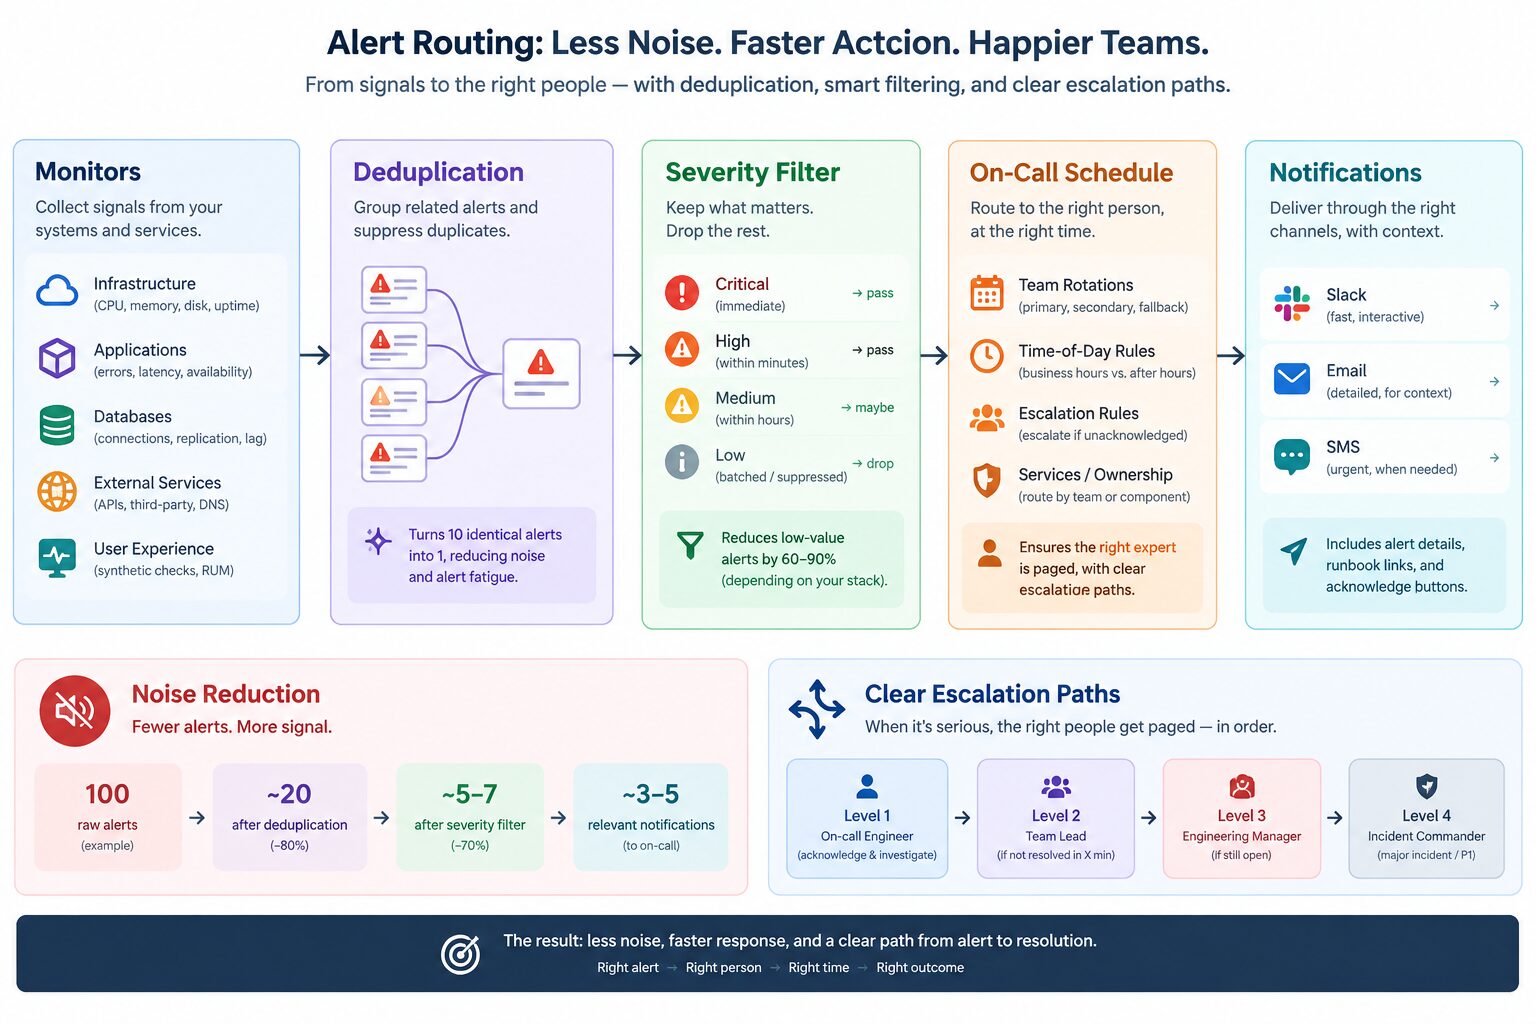
Ton but n’est pas d’être réveillé pour un pic de latence éphémère. Mets en place des garde‑fous :
- Seuils dynamiques et périodes d’évaluation (ex. 5/10 min) pour filtrer les à‑coups.
- Déduplication et suppression des doublons (même cause, même incident).
- Routing par sévérité : P1 (SMS + appel) / P2 (Slack + email) / P3 (ticket).
- Horaires d’astreinte et escalade progressive.
- Silences planifiés pendant les maintenances et déploiements.
Résultat : des notifications ciblées, avec un message actionnable (impact client, composant, hypothèse racine, runbook, lien vers dashboard/logs).
Métriques, logs et traces : la boîte noire de ton site
Pour diagnostiquer vite, corrèle trois piliers :
- Métriques : temps de réponse (TTFB), CPU/RAM, I/O disque, connexions DB, taux d’erreur PHP.
- Logs : accès Nginx/Apache, erreurs PHP, logs applicatifs (soumission formulaire, paiement).
- Traces : suivi d’une requête à travers WordPress, plugins, DB, API externes.
Active un identifiant de corrélation (header X‑Request‑ID) et ajoute‑le à tes logs applicatifs. Loggue les événements métiers clés (ex. “lead_created”, “order_paid”). Astuce : un échantillonnage adaptatif des traces réduit les coûts tout en gardant les cas lents/erreurs.
Architecture type pour TPE/PME : simple, robuste, mesurable
Inutile de sur‑outiller. Vise un combo léger et fiable :
- Uptime : sondes HTTP/TLS multi‑régions avec quorum.
- Cron : cron système + métriques d’exécution + alerte en cas de retard/échec.
- Synthétique : 2–3 parcours, 5–15 min, captures et export des erreurs.
- Observabilité : métriques serveur + logs centralisés + traces sur endpoints lents.
- Alerting : SLO + burn rate + routing par sévérité vers Slack/email/SMS.
Chez WP Builders, on privilégie l’efficacité : peu de sondes, très bien calibrées, des tableaux de bord lisibles et des runbooks maintenus. Tu sais ce qui se passe et quoi faire quand ça casse.
Monitoring WordPress sans bruit, dès aujourd’hui
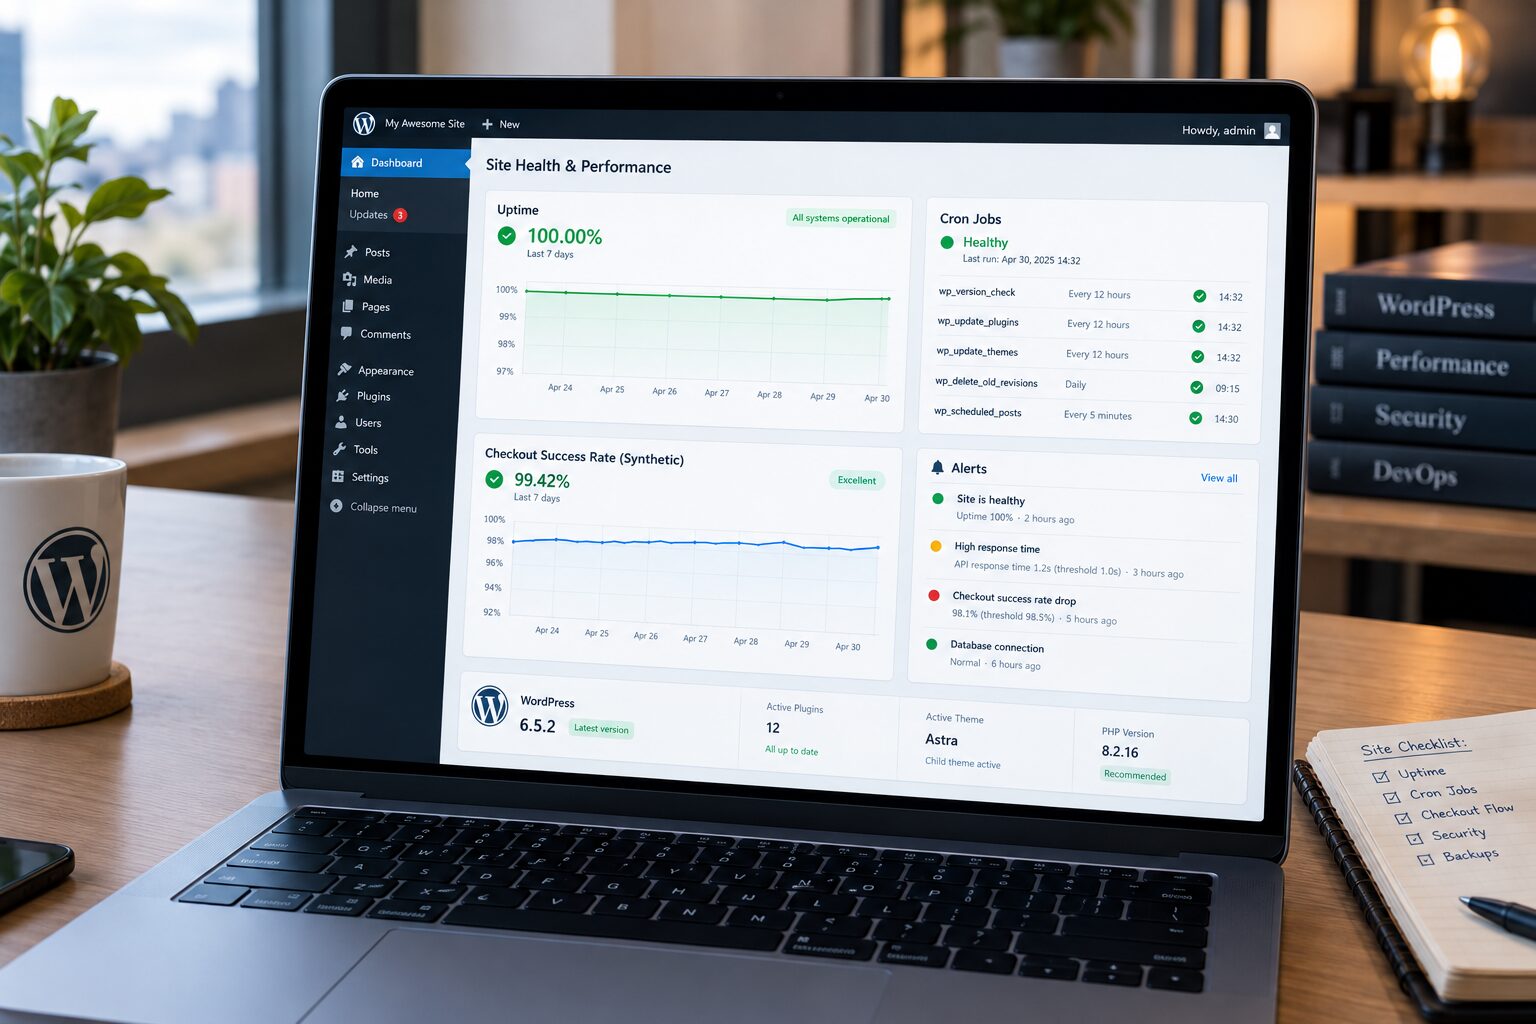
On installe des sondes utiles, on définit des SLO réalistes et on filtre les alertes. Intervention possible en moins de 2 heures.
Plan d’implémentation en 90 minutes
- Cartographie (10 min) : URLs critiques, dépendances (DB, CDN, API paiement), horaires business.
- Sondes d’uptime (10 min) : 3 régions, 200 + TTFB + mot‑clef, quorum 2/3, fenêtre de maintenance.
- Cron (15 min) : activer cron système, logs, seuils sur jobs critiques, test WP‑CLI.
- Parcours synthétiques (20 min) : contact + checkout sandbox, assertions fortes, captures.
- SLO (10 min) : 99,9 % uptime, 99 % contact, 99,5 % checkout, budget d’erreur mensuel.
- Alerting (10 min) : burn rate deux fenêtres (ex. 5 min et 1 h), dédup, routing P1/P2/P3.
- Notifications (5 min) : Slack #alerts, email ops@, SMS on‑call, plages horaires.
- Runbooks (5 min) : pas‑à‑pas incident, checklists, contacts hébergeur/paiement.
- Chaos test (3 min) : couper wp‑cron, forcer une 500, vérifier l’alerte et l’escalade.
- Revue (2 min) : valider les tableaux de bord et le reporting SLO.
Mapping signaux → sources → alertes
- HTTP 5xx répétés → logs serveur + métriques PHP‑FPM → Alerte P1 immédiate si > 5 %/5 min.
- TTFB > seuil → métriques CPU/I/O + traces WP → Alerte P2 si > 3 min consécutives.
- Cron en retard → logs wp‑cron + queue Action Scheduler → P1 si job critique manque 2 runs.
- Checkout échec → test synthétique + logs paiement → P1 si taux d’échec > 2 %/15 min.
- Formulaire silencieux → test synthétique + email catch + DB insert → P2 si 3 échecs.
Bonnes pratiques d’exploitation
- Runbooks vivants : mets à jour après chaque incident (post‑mortem court, actions).
- Fenêtres de maintenance déclarées, et tests synthétiques désactivés si changement majeur UX.
- Staging surveillé mais non alertant (ou alertes P3 seulement).
- Test d’alerte mensuel pour vérifier numéros, canaux et escalades.
- Versionnage des dashboards et de la configuration d’alerting.
Mesurer la valeur : KPI qui comptent
- MTTD/MTTR : temps de détection et de résolution.
- Change Failure Rate : incidents par déploiement.
- Respect SLO : mois en vert/rouge, budget d’erreur consommé.
- Taux d’alertes actionnables : proportion d’alertes ayant conduit à une action réelle.
- Taux de faux positifs : à réduire < 5 %.
Outils et intégrations pratiques
Quel que soit l’outillage que tu choisis, garde la logique : peu de sondes, bien calibrées, et un alerting SLO‑driven avec notifications maîtrisées. Si tu veux un accompagnement clé en main, WP Builders te conçoit un setup sobre et efficace, documenté et maintenu dans le temps.
Conclusion
Un monitoring WordPress de niveau pro, ce n’est pas “plus d’outils”, c’est mieux d’outils : uptime pertinent, cron fiable, synthetic monitoring sur tes parcours critiques, SLO lisibles et alerting sans bruit. Tu protèges l’expérience, ton SEO et tes revenus. Tu dors mieux, aussi. Et si tu veux aller vite et bien, on peut le faire pour toi, puis rester en veille 24/7 pour détecter, diagnostiquer et corriger avant que tes clients ne s’en aperçoivent.